Una bomba que para sin aviso puede interrumpir una línea entera, comprometer los plazos de entrega y elevar los costos de mantenimiento de emergencia. Es en ese punto donde un caso de uso de mantenimiento predictivo deja de ser solo una iniciativa de Inteligencia Artificial y se convierte en una decisión operacional con impacto directo en disponibilidad, margen y riesgo.
La propuesta es simple en teoría: usar datos de equipos para identificar señales de degradación antes de que ocurra una falla. En la práctica, el resultado depende de una arquitectura capaz de recopilar señales confiables, contextualizarlas con la operación y transformar predicciones en órdenes de trabajo que tengan sentido para el equipo de mantenimiento.
Qué caracteriza un caso de uso de mantenimiento predictivo
El mantenimiento correctivo ocurre después de la falla. El preventivo sigue un calendario o una métrica fija de uso, como horas de operación o ciclos. El mantenimiento predictivo estima la condición real del activo con base en datos históricos y señales observadas en tiempo casi real.
Esto no significa que todas las máquinas necesiten nuevos sensores o modelos complejos. Un proyecto bien estructurado comienza por la criticidad del activo y el costo de su indisponibilidad. En muchos entornos industriales, los datos ya existentes en sistemas SCADA, PLC, historiadores, ERPs y plataformas de gestión de mantenimiento contienen señales suficientes para iniciar el análisis.
El foco no es predecir cualquier anomalía. Es responder preguntas que apoyen decisiones concretas: ¿qué equipo tiene mayor probabilidad de falla en los próximos días? ¿Qué variable se está alejando del comportamiento esperado? ¿Qué intervención debe priorizarse en la próxima ventana de mantenimiento? ¿Cuál es el impacto de posponer esa acción?
Ejemplo práctico: monitoreo de bombas críticas
Considere una operación industrial con bombas centrífugas responsables de alimentar una etapa continua de producción. Una falla en una unidad puede reducir la capacidad, afectar la calidad del producto o requerir una parada no programada. Aunque la planta cuente con inspecciones periódicas, hay casos en que el desgaste evoluciona entre una ronda y otra.
En ese escenario, la empresa puede integrar datos de vibración, temperatura de los cojinetes, presión de succión y descarga, caudal, consumo eléctrico, velocidad de rotación y horas acumuladas de funcionamiento. Estas señales ganan más valor cuando se cruzan con información de contexto, como tipo de fluido, régimen de carga, historial de intervenciones, piezas reemplazadas y ocurrencias anteriores.
Un aumento aislado de temperatura, por ejemplo, no confirma una falla. Puede deberse a un cambio temporal de carga o a condiciones ambientales. Pero el aumento gradual de temperatura asociado a cambios de vibración y mayor consumo de energía puede indicar desalineamiento, cavitación, desgaste de rodamiento o pérdida de eficiencia hidráulica.
El modelo analítico no sustituye la evaluación del técnico. Prioriza la atención humana al señalar equipos con comportamiento fuera de lo normal y al presentar las variables que explican la alerta. De esta forma, el equipo deja de inspeccionar todos los activos con la misma intensidad y comienza a concentrar recursos donde el riesgo operacional es mayor.
De la telemetría a la decisión de mantenimiento
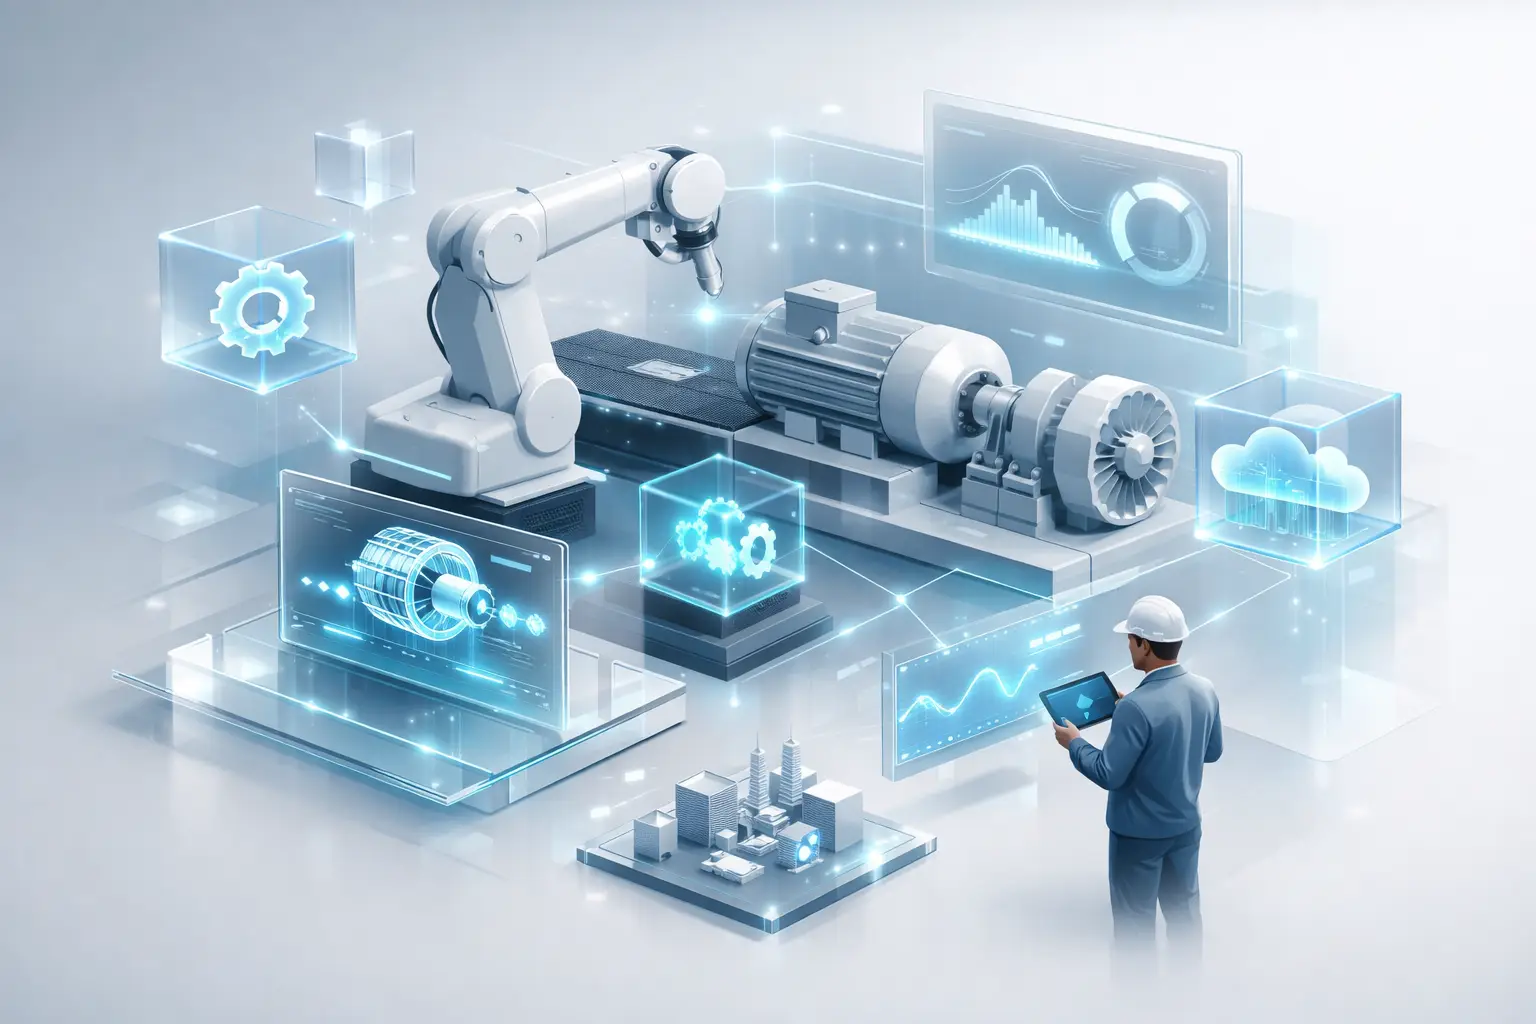
El flujo comienza en el borde, con la captura de datos por sensores, gateways industriales o integraciones con sistemas existentes. La transmisión debe considerar requisitos de conectividad, seguridad y continuidad operacional. En plantas con conectividad limitada, parte del procesamiento puede ocurrir localmente, con envío posterior de datos consolidados a la nube.
En la capa de datos, las lecturas necesitan estandarizarse, validarse y relacionarse con el registro correcto de cada activo. Este punto parece operacional, pero suele definir el éxito de la iniciativa. Etiquetas inconsistentes, sensores sin calibración, lagunas de historial y registros de mantenimiento poco detallados reducen la confiabilidad de cualquier modelo.
En una arquitectura moderna en AWS, servicios como AWS Glue y Amazon EMR pueden apoyar la preparación y el procesamiento de grandes volúmenes de datos históricos. Las funciones con AWS Lambda pueden automatizar tratamientos y alertas, mientras que los paneles en Amazon QuickSight brindan visibilidad sobre indicadores de salud de los equipos, anomalías y rendimiento de las acciones ejecutadas.
Después de la preparación, entran las técnicas analíticas. Para activos con historial confiable de fallas, los modelos supervisados pueden estimar la probabilidad de falla o la vida útil remanente. Cuando los eventos de falla son raros — lo que es común en equipos bien mantenidos — los modelos de detección de anomalías suelen ser más adecuados. Aprenden el patrón de operación normal y señalan desviaciones relevantes.
La salida debe llegar al proceso de mantenimiento con criterios objetivos. En lugar de una alerta genérica, el equipo necesita recibir algo como: «bomba B-14 con índice de riesgo elevado, aumento progresivo de vibración en el eje X, impacto estimado en disponibilidad y recomendación de inspección en la próxima parada programada».
Dónde está el retorno financiero
La ganancia no proviene simplemente de la implementación de sensores o de un modelo de Machine Learning. Aparece cuando la empresa reduce las paradas no planificadas, evita daños secundarios, mejora la planificación de piezas y aumenta el tiempo medio entre fallas.
En una operación con equipos críticos, una intervención planificada tiende a requerir menos recursos que un mantenimiento de emergencia. El equipo puede programar la mano de obra, disponer la pieza correcta, elegir una ventana con menor impacto productivo y evitar que una falla inicial genere daños en otros componentes.
También existe una ganancia en la gestión de inventario. Cuando el mantenimiento puede anticipar riesgos con un nivel razonable de confianza, la empresa reduce tanto la urgencia de compras como la necesidad de mantener piezas de alto costo en exceso. El equilibrio depende del plazo de reposición, la criticidad del artículo y el costo de la indisponibilidad.
Para medir el resultado, se recomienda monitorear indicadores como la reducción de paradas no programadas, el costo por orden de trabajo, el tiempo medio para reparación, el tiempo medio entre fallas, la disponibilidad de los activos y la precisión de las alertas. El indicador más relevante varía según el objetivo del negocio. En una planta de proceso continuo, la disponibilidad puede ser la métrica principal. En una flota, el foco puede estar en el costo de mantenimiento por kilómetro y el cumplimiento de rutas.
Los límites que deben considerarse
El mantenimiento predictivo no es una solución indicada para todos los activos. Los equipos de bajo costo, fácil reemplazo y poca influencia sobre la producción pueden estar mejor atendidos por estrategias preventivas o correctivas planificadas. Aplicar sensores y modelos avanzados en estos casos puede costar más que el beneficio esperado.
Otro límite es la calidad de los datos. Si el historial de fallas no identifica la causa, el componente afectado, la fecha y la condición operacional, el modelo tendrá dificultades para generar recomendaciones confiables. Antes de ampliar la iniciativa, muchas organizaciones necesitan evolucionar procesos básicos de registro, taxonomía de activos y gobernanza de datos.
También existe el riesgo de exceso de alertas. Un sistema que señala desviaciones sin relevancia operacional pierde credibilidad rápidamente. Por eso, los umbrales de riesgo, las reglas de escalado y la interfaz con los técnicos deben calibrarse de forma continua. La experiencia del equipo de campo es parte esencial de ese ajuste.
Cómo estructurar la implementación con menor riesgo
El camino más consistente es comenzar con un alcance controlado: un grupo de activos críticos, una falla relevante y una hipótesis de valor medible. En lugar de intentar monitorear toda la planta, la empresa puede seleccionar equipos con historial de indisponibilidad, alto costo de reparación o impacto directo en la producción.
El siguiente paso es evaluar la disponibilidad, calidad y frecuencia de los datos. Después, es necesario construir la línea de base operacional, entender cómo el equipo se comporta en condiciones normales y definir qué se considerará una alerta útil. Solo entonces el modelo debe integrarse a los flujos de mantenimiento y a los paneles de gestión.
ST IT Cloud apoya este tipo de camino conectando arquitectura de datos, IoT, Cloud e Inteligencia Artificial a objetivos operacionales claros. La prioridad no es solo generar predicciones, sino crear una base segura, escalable y gobernada para que el área de mantenimiento tome decisiones con confianza.
El mejor primer paso es elegir una falla que hoy cuesta caro, reunir los datos disponibles y calcular el valor de evitarla. Cuando la predicción comienza a orientar una acción planificada en el piso de fábrica, la tecnología deja de ser una promesa y comienza a proteger la operación.